

1. 데이터 분석이란?
데이터 분석이란 수집된 데이터를 여러 방법으로 처리하고 분석하여 데이터 속에서 의미 있는 정보나 특징을 찾아내는 과정이다.
2. 데이터 분석 과정
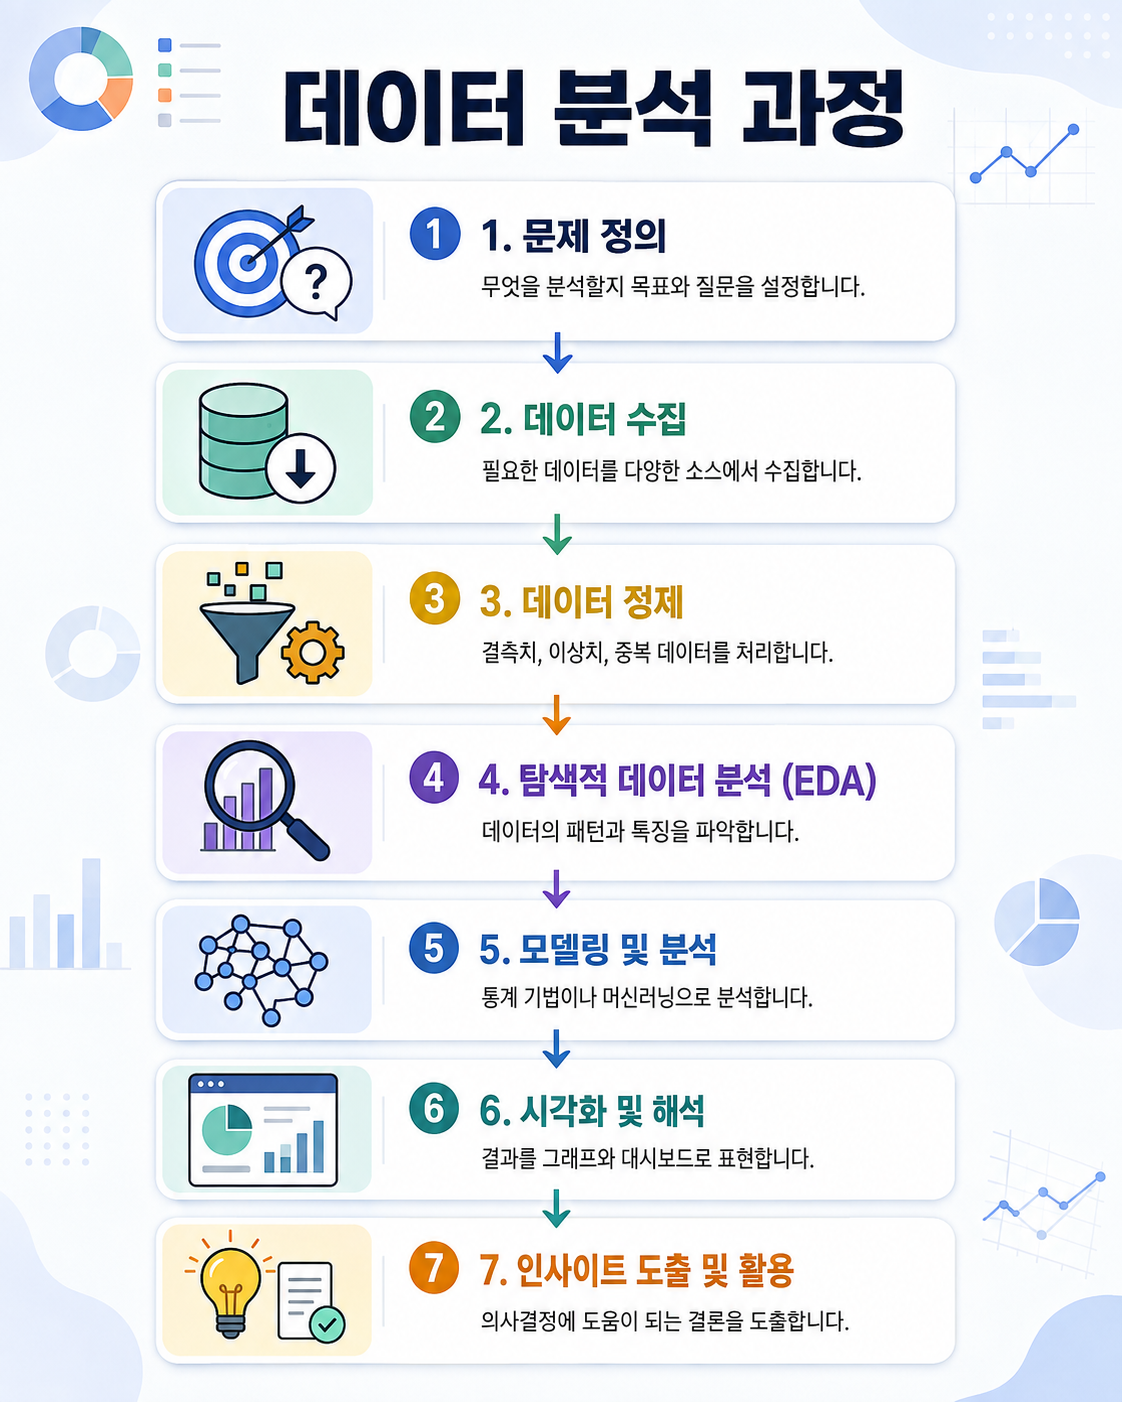
데이터 분석은 데이터를 단순히 확인하는 것이 아니라, 문제를 정의하고 데이터를 수집·정리한 뒤 분석을 통해 의미 있는 결과를 찾아가는 과정이다.
(1) 문제 정의
가장 먼저 무엇을 분석할 것인지 목표를 정한다.
(2) 데이터 수집
분석에 필요한 데이터를 수집한다.
수집 방법: 데이터는 공공데이터, CSV 파일, 데이터베이스, API, 웹 크롤링 등 다양한 방법으로 얻을 수 있다.
(3) 데이터 정제
수집한 데이터에는 결측치나 중복값, 이상치 등이 포함될 수 있다. 이런 데이터를 수정하거나 제거하여 분석하기 좋은 형태로 정리하는 과정이다.
(4) 탐색적 데이터 분석
정리된 데이터를 그래프나 통계값으로 확인하며 데이터의 특징과 패턴을 찾아보는 과정이다. 이를 통해 변수 간의 관계나 예상하지 못했던 특징을 발견할 수 있다.
(5) 모델링 및 분석
분석 목적에 맞게 통계 기법이나 머신러닝 모델을 활용한다. 예측, 분류, 군집화 등 문제에 적절한 방법을 선택하여 데이터를 분석한다.
(6) 시각화 및 해석
분석 결과를 그래프나 차트로 표현하여 쉽게 이해할 수 있도록 만든다. 단순히 시각화하는 것뿐만 아니라 결과가 어떤 의미를 가지는지 해석하는 과정도 중요하다.
(7) 인사이트 도출 및 활용
마지막으로 분석 결과를 바탕으로 실제 문제 해결이나 의사결정에 활용할 수 있는 결론을 도출한다.
데이터 분석은 이러한 과정을 반복하면서 데이터 속에서 의미 있는 정보를 발견하고, 이를 실제 문제 해결에 활용하는 과정이라고 할 수 있다.
3. 데이터 시각화
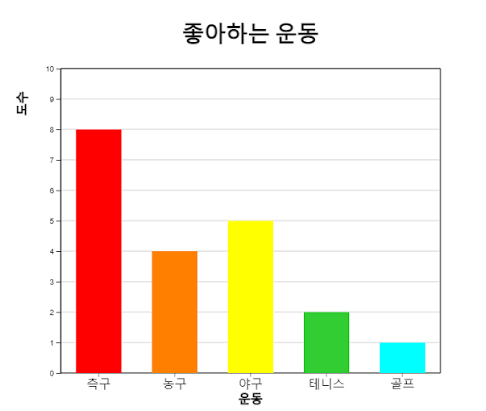
데이터를 그래프나 차트로 나타내어 데이터의 특징이나 변화를 한눈에 이해할 수 있도록 하는 것이다.
4. Numpy
NumPy는 데이터 분석과 시각화에 필요한 수치 계산을 효율적으로 처리하기 위한 라이브러리이다.
(1) numpy 불러오기
import numpy as npnumpy를 import 해 불러오는 코드이다.
(2) 배열 만들기
data = np.array([10, 20, 30, 40, 50])
print(data)
print(data[0])
print(data[2])배열을 만드는 코드이다. 순서대로 데이터 전체 출력, 배열 0번째 값, 배열 2번째 값을 출력하는 코드이다.
(3) 일정한 배열 만들기
data = np.arange(1, 10)
print(data)데이터를 1~ 9까지 배열로 만들고 출력하는 코드이다.
[1,2,3,4,5,6,7,8,9]가 출력될 것이다.
(4) 특정한 배열 만들기
print(np.zeros(5)) // 0 배열print(np.ones(5)) // 1배열첫 번째 코드는 0을 5개만큼 넣은 배열을 만들고 두 번째 코드는 1을 5개만큼 넣은 배열을 만드는 코드이다.
-
[0,0,0,0,0]이 출력될 것이다.
-
[1,1,1,1,1]이 출력될 것이다.
(5) 데이터 분석하기
data = np.array([72, 85, 91, 64, 88, 95, 78, 83])
print("평균:", np.mean(data))print("최댓값:", np.max(data))print("최솟값:", np.min(data))print("합계:", np.sum(data))print("표준편차:", np.std(data))데이터를 배열로 만든 뒤 순서대로 평균, 최댓값, 최솟값, 합계, 표준편차를 계산해 주는 코드이다.
데이터의 평균: 82.0
데이터의 최댓값: 95
데이터의 최솟값: 64
데이터의 합계: 656
데이터의 표준편차: 9.591663046625438 이 출력될 것이다.
(6) 연습하기
-
배열의 모든 요소를 출력하세요.
-
배열의 요소 중 최댓값을 출력하세요.
-
배열의 요소 중 최솟값을 출력하세요.
-
배열의 요소의 평균값을 출력하세요.
-
배열의 형태를 2행 5열로 변경한 후 출력하세요. 단, 새로운 변수를 만들어 사용하세요.
사용하는 데이터 -> scores = np.array([75, 82, 91, 68, 88, 95, 79, 84, 90, 73])
풀이
scores = np.array([75, 82, 91, 68, 88, 95, 79, 84, 90, 73])
print(data) #배열 전체 출력print(np.max(data))#최댓값 출력print(np.min(data)) #최솟 출력print(np.mean(data)) # 평균 출력a = scores.reshape(2,5) # 2행 5열print(a)(7) Numpy의 주요 명령어
| np.array() | 배열 생성 | np.array([1, 2, 3]) |
|---|---|---|
| np.arange() | 일정한 간격으로 배열 생성 | np.arange(1, 10) → 1부터 9까지 생성 |
| np.zeros() | 0으로 채워진 배열 생성 | np.zeros(5) → 0을 5개 생성 |
| np.ones() | 1로 채워진 배열 생성 | np.ones(5) → 1을 5개 생성 |
| np.mean() | 평균 계산 | np.mean(data) |
| np.max() | 최댓값 계산 | np.max(data) |
| np.min() | 최솟값 계산 | np.min(data) |
| np.sum() | 전체 합계 계산 | np.sum(data) |
| np.std() | 표준편차 계산 | np.std(data) |
| np.reshape() | 배열의 형태 변경 | data.reshape(2, 3) → 2행 3열로 변경 |
5. pandas
Python에서 표 형태의 데이터를 쉽게 다루고 분석할 수 있도록 도와주는 라이브러리이다.
(1) pandas 불러오기
import pandas as pdpandas를 import 해 불러오는 코드이다.
(2) 데이터 만들기
data = {
'이름': ['A', 'B', 'C', 'D', 'E'], # 이름 데이터'점수': [80, 90, 75, 95, 85], # 점수 데이터'학년': [1, 1, 2, 2, 1] # 학년 데이터
}data는 학생의 이름, 점수, 학년 정보를 딕셔너리 형태로 저장한 데이터이다. 각 항목은 리스트로 구성되어 있으며, 이후 Pandas의 DataFrame으로 변환해 표 형태로 사용할 수 있다.
(3) Dataframe으로 변환후 출력
df = pd.DataFrame(data)print(df)데이터를 Dataframe으로 변환해 표로 출력하는 코드이다.
이름 점수 학년
0 A 80 1
1 B 90 1
2 C 75 2
3 D 95 2
4 E 85 1
이렇게 출력된다.
(4) 데이터 출력하기
print(df.head())데이터의 처음 5개 값이 출력된다.
(5) 특정 열 데이터 출력
print(df['점수'])특정 열 데이터 출력을 하는 코드이다.
(6) 데이터 분석
# 점수의 평균 계산print("평균:", df['점수'].mean())
# 점수의 최댓값 계산print("최댓값:", df['점수'].max())
# 점수의 최솟값 계산print("최솟값:", df['점수'].min())데이터의 평균 , 최댓값 , 최솟값을 계산하는 코드이다.
(7) 수치 데이터의 기본 통계 정보출력
print(df.describe())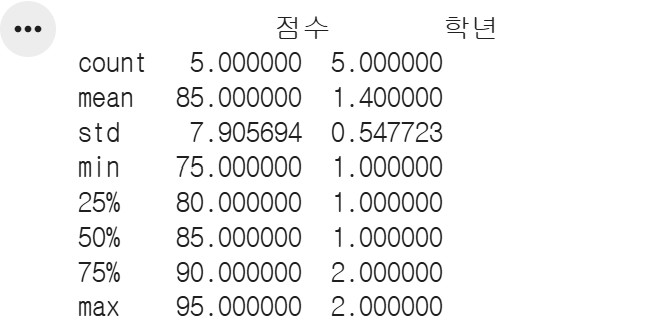
(8) 연습하기
-
전체 데이터를 출력하세요.
-
‘점수’ 열의 데이터를 출력하세요.
-
점수의 평균값을 출력하세요.
-
점수의 최댓값을 출력하세요.
-
점수의 최솟값을 출력하세요.
-
describe()를 이용하여 기본 통계 정보를 확인하세요.
-
head()를 이용하여 데이터의 처음 5개 행을 출력하세요.
풀이
data = { '이름': ['A', 'B', 'C', 'D', 'E'], '점수': [78, 92, 85, 96, 74], '학년': [1, 1, 2, 2, 1]}df = pd.DataFrame(data)print(df) # 전체 데이터 출력
print(df['점수']) # 점수 열 출력
print("평균:", df['점수'].mean()) # 평균 계산
print("최댓값:", df['점수'].max()) # 최댓값 계산
print("최솟값:", df['점수'].min()) # 최솟값 계산
print(df.describe()) # 통계 정보 출력
print(df.head()) # 처음 5개 행 출력(8) pandas의 주요 명령어
명령어기능예시
| pd.DataFrame() | 데이터프레임 생성 | pd.DataFrame(data) |
|---|---|---|
| df.head() | 처음 5개의 데이터 확인 | df.head() |
| df.tail() | 마지막 5개의 데이터 확인 | df.tail() |
| df.info() | 데이터의 기본 정보 확인 | df.info() |
| df.describe() | 수치형 데이터의 통계 정보 확인 | df.describe() |
| df[‘열이름’] | 특정 열 선택 | df[‘점수’] |
| df.mean() | 평균 계산 | df[‘점수’].mean() |
| df.max() | 최댓값 계산 | df[‘점수’].max() |
| df.min() | 최솟값 계산 | df[‘점수’].min() |