1. 자연어 처리란?
사람이 사용하는 언어를 컴퓨터가 이해하고 처리하도록 만드는 기술
예시) 번역기, 챗봇, 스팸 메일 분류, 문서 요약
2. 자연어 처리 과정
문장 입력 → 전처리 → 숫자로 변환 → 모델 학습 → 결과 예측1. 문장 입력
분석할 말이나 글을 컴퓨터에 입력한다.
예: “이 영화 정말 재미있다!”
2. 전처리
문장을 분석하기 좋은 형태로 정리합니다. 필요에 따라 불필요한 기호를 제거하고, 문장을 작은 단위인 토큰으로 나눈다.
예: 이 / 영화 / 정말 / 재미있다
3. 숫자로 변환
컴퓨터가 계산할 수 있도록 토큰을 숫자나 숫자들의 묶음인 벡터로 바꿉니다. 단어의 의미와 관계를 벡터로 표현하는 방법을 임베딩이라고 한다.
예: 영화 → [0.2, -0.4, 0.7, …]
4. 모델 학습
많은 문장과 정답을 보여주고, 예측이 정답에 가까워지도록 모델의 내부 값을 조정한다.
예: “재미있다” → 긍정, “지루하다” → 부정
이 과정을 반복하면서 학습한다.
5. 결과 예측
학습한 모델이 새로운 문장을 분석해 결과를 낸다.
예: “정말 재미있어서 다시 보고 싶다” → 긍정
학습이 끝난 모델을 사용할 때는 매번 다시 학습하지 않고, 새 문장 입력 → 전처리 → 숫자로 변환 → 학습된 모델로 예측하는 과정을 거친다고 한다.
3. 텍스트 전처리
컴퓨터가 문장을 분석하고 학습하기 쉽도록 불필요한 부분을 정리하고, 처리하기 좋은 형태로 바꾸는 과정
(1) 토큰화: 문장을 단어나 의미를 가진 작은 단위로 나누는 방법
예) “이 영화 정말 재미있다” → [“이”, “영화”, “정말”, “재미있다”]
(2) 텍스트 정규화: 같은 의미의 표현을 일정한 형태로 정리하는 방법
예) “IRISㅋㅋ” → “IRIS”
특수문자나 불필요한 표현을 제거할 수 있다.
4. 형태소 분석
문장을 의미를 가진 가장 작은 단위인 형태소로 나누고, 각 형태소의 품사와 역할을 분석하는 방법
예) “현우는 아프다” → 현우 / 는 / 아프 / 다
한국어는 조사와 어미가 붙어 단어의 형태가 다양하게 바뀌기 때문에, 문장의 구조와 의미를 파악하는 데 형태소 분석이 중요하다.
5. 벡터화
머신러닝 모델은 글자를 그대로 이해하거나 계산하기 어렵다.
그래서 단어나 문장을 컴퓨터가 처리할 수 있는 숫자의 배열(벡터)로 바꾸어야 이해하고, 계산 할 수 있다.
이 과정을 벡터화라고 부른다.
예) “현우는 아프다” → [0.2, 0.7, -0.3, …]
벡터화를 통해 컴퓨터는 단어의 의미와 단어 사이의 관계를 학습할 수 있다.
6. Bag of Words
문장에 각 단어가 몇 번 등장했는지를 세어 숫자로 표현하는 벡터화 방법
예)
- 문장: “나는 영화가 좋다 나는 행복하다”
- 단어 목록: [나는, 영화가, 좋다, 행복하다]
- 벡터: [2, 1, 1, 1]
(1) 장점: 구조가 간단하고 이해하기 쉬움
(2) 단점: 단어의 순서와 문맥을 반영하기 어려움
7. TF-IDF
특정 문서에는 자주 등장하지만, 다른 문서에서는 드물게 등장하는 단어에 더 높은 중요도를 부여하는 벡터화 방법
TF: 한 문서에서 특정 단어가 등장하는 빈도
IDF: 전체 문서에서 특정 단어가 얼마나 드문지를 나타내는 값
문서의 핵심 내용이나 특징을 나타내는 단어를 찾는 데 활용
8. 실습
(1) 라이브러리 불러 오기
# 셀 1. 라이브러리 불러오기
import re # 특수문자 제거import pandas as pdfrom sklearn.feature_extraction.text import TfidfVectorizerfrom sklearn.linear_model import LogisticRegression
print("라이브러리 불러오기 완료!")셀 1에서는 자연어 처리와 머신러닝에 필요한 라이브러리를 불러온다. re는 문장에 포함된 특수문자를 제거하는 데 사용하고, pandas는 데이터를 표 형태로 정리하고 처리하는 데 사용한다. TfidfVectorizer는 텍스트를 TF-IDF 방식의 숫자 벡터로 변환하며, LogisticRegression은 변환된 데이터를 학습하고 문장을 분류하는 모델이다. 마지막으로 print()를 사용해 라이브러리를 정상적으로 불러왔다는 메시지를 출력한다.
(2) 학습 데이터
# 셀 2. 학습 데이터
positive_texts = [ "정말 좋다", "정말 마음에 든다", "너무 만족스럽다", "아주 훌륭하다", "정말 잘했다", "최고였다", "매우 좋았다", "잘한 것 같다", "정말 괜찮다", "생각보다 좋다",
"다시 뽑고 싶다", "다음에도 뽑고 싶다", "다시 함께하고 싶다", "다음에도 같이 활동하고 싶다", "같이 활동해서 즐거웠다", "함께해서 좋았다", "다시 만나고 싶다", "계속 같이하고 싶다",
"좋은 부원이다", "훌륭한 부원이다", "믿을 만한 부원이다", "책임감 있는 부원이다", "성실한 부원이다", "열심히 하는 부원이다", "적극적인 부원이다",
"책임감 있게 행동했다", "맡은 일을 잘했다", "맡은 일을 끝까지 해냈다", "자신의 역할을 잘 수행했다", "활동에 열심히 참여했다", "활동에 적극적으로 참여했다", "프로젝트에 적극적이었다", "팀 활동에 열심히 참여했다",
"팀에 도움이 되었다", "팀에 많은 도움이 되었다", "팀원들에게 도움이 되었다", "프로젝트에 큰 도움이 되었다", "좋은 결과를 만들었다", "결과가 만족스럽다", "결과가 매우 좋았다",
"실력이 좋다", "실력이 뛰어나다", "능력이 좋다", "잘하는 것 같다", "생각보다 잘한다", "기대 이상으로 잘했다",
"태도가 좋았다", "성격이 좋다", "친절하다", "협력을 잘한다", "의사소통을 잘한다",
"현우는 정상적이다", "현우는 정말 괜찮다", "도근이의 관제탑은 최고였다", "도근이는 정말 잘했다", "예건이는 마음에 들었다", "예건이는 정말 좋았다"]
negative_texts = [ "정말 싫다", "정말 마음에 안 든다", "너무 실망스럽다", "아주 별로다", "정말 못했다", "최악이었다", "매우 좋지 않았다", "못한 것 같다", "정말 별로다", "생각보다 안 좋다",
"다시 뽑고 싶지 않다", "다음에는 뽑고 싶지 않다", "다시 함께하고 싶지 않다", "다음에는 같이 활동하고 싶지 않다", "같이 활동하기 힘들었다", "함께해서 힘들었다", "다시 만나고 싶지 않다", "계속 같이하고 싶지 않다",
"좋은 부원이 아니다", "훌륭한 부원이 아니다", "믿기 어려운 부원이다", "책임감 없는 부원이다", "성실하지 않은 부원이다", "열심히 하지 않는 부원이다", "소극적인 부원이다",
"책임감 없이 행동했다", "맡은 일을 못했다", "맡은 일을 끝내지 않았다", "자신의 역할을 제대로 수행하지 않았다", "활동에 제대로 참여하지 않았다", "활동에 소극적으로 참여했다", "프로젝트에 소극적이었다", "팀 활동에 참여하지 않았다",
"팀에 도움이 되지 않았다", "팀에 별로 도움이 되지 않았다", "팀원들에게 피해를 줬다", "프로젝트에 도움이 되지 않았다", "좋지 않은 결과를 만들었다", "결과가 실망스럽다", "결과가 매우 좋지 않았다",
"실력이 부족하다", "실력이 좋지 않다", "능력이 부족하다", "잘하지 못하는 것 같다", "생각보다 못한다", "기대 이하로 못했다",
"태도가 좋지 않았다", "성격이 좋지 않다", "불친절하다", "협력을 잘하지 않는다", "의사소통을 잘하지 않는다",
"현우는 아프다", "현우는 정말 별로다", "도근이의 관제탑은 최악이었다", "도근이는 정말 못했다", "예건이는 마음에 안 들었다", "예건이는 정말 별로였다"]
texts = positive_texts + negative_texts
labels = ( [1] * len(positive_texts) + [0] * len(negative_texts))
print("전체 데이터:", len(texts))print("긍정 데이터:", labels.count(1))print("부정 데이터:", labels.count(0))셀 2에서는 모델을 학습시키기 위한 문장 데이터를 준비한다. positive_texts에는 “정말 좋다”, “책임감 있게 행동했다”처럼 긍정적인 문장을 저장하고, negative_texts에는 “정말 싫다”, “맡은 일을 못했다”처럼 부정적인 문장을 저장한다.
texts에는 긍정 문장과 부정 문장을 하나로 합쳐 저장한다. labels에는 각 문장의 정답을 저장하며, 긍정 문장은 1, 부정 문장은 0으로 표시한다. len()과 count()를 사용해 전체 문장 수와 긍정·부정 문장 수를 확인한다. 이 데이터는 이후 모델이 문장의 긍정과 부정을 구분하도록 학습하는 데 사용한다.
(3) 텍스트 잔처리
# 셀 3. 텍스트 전처리
def clean_text(text): text = re.sub(r"[^가-힣\s]","",text) return text
clean_texts = [clean_text(text) for text in texts]
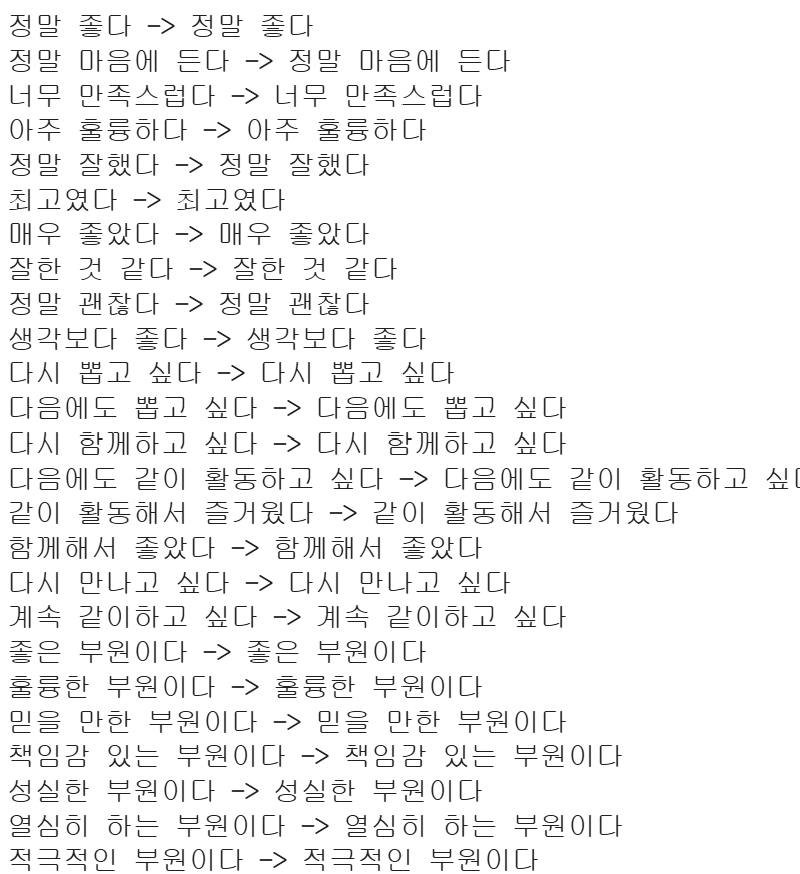
for before, after in zip(texts,clean_texts): print(before,"->",after)셀 3에서는 모델이 문장을 쉽게 학습할 수 있도록 텍스트를 전처리한다. clean_text() 함수는 정규표현식 [^가-힣\s]을 사용해 한글과 공백을 제외한 숫자, 영문, 특수문자 등을 제거한다.
이 함수를 texts의 모든 문장에 적용하고, 전처리된 결과를 clean_texts에 저장한다. 마지막으로 zip()을 사용해 전처리 전 문장과 전처리 후 문장을 함께 출력하여 어떻게 달라졌는지 확인한다.
(4) TF-IDF 변환
# 셀 4. TF-IDF 변환
vectorizer = TfidfVectorizer()X = vectorizer.fit_transform(clean_texts)
print("단어 목록:")print(vectorizer.get_feature_names_out())
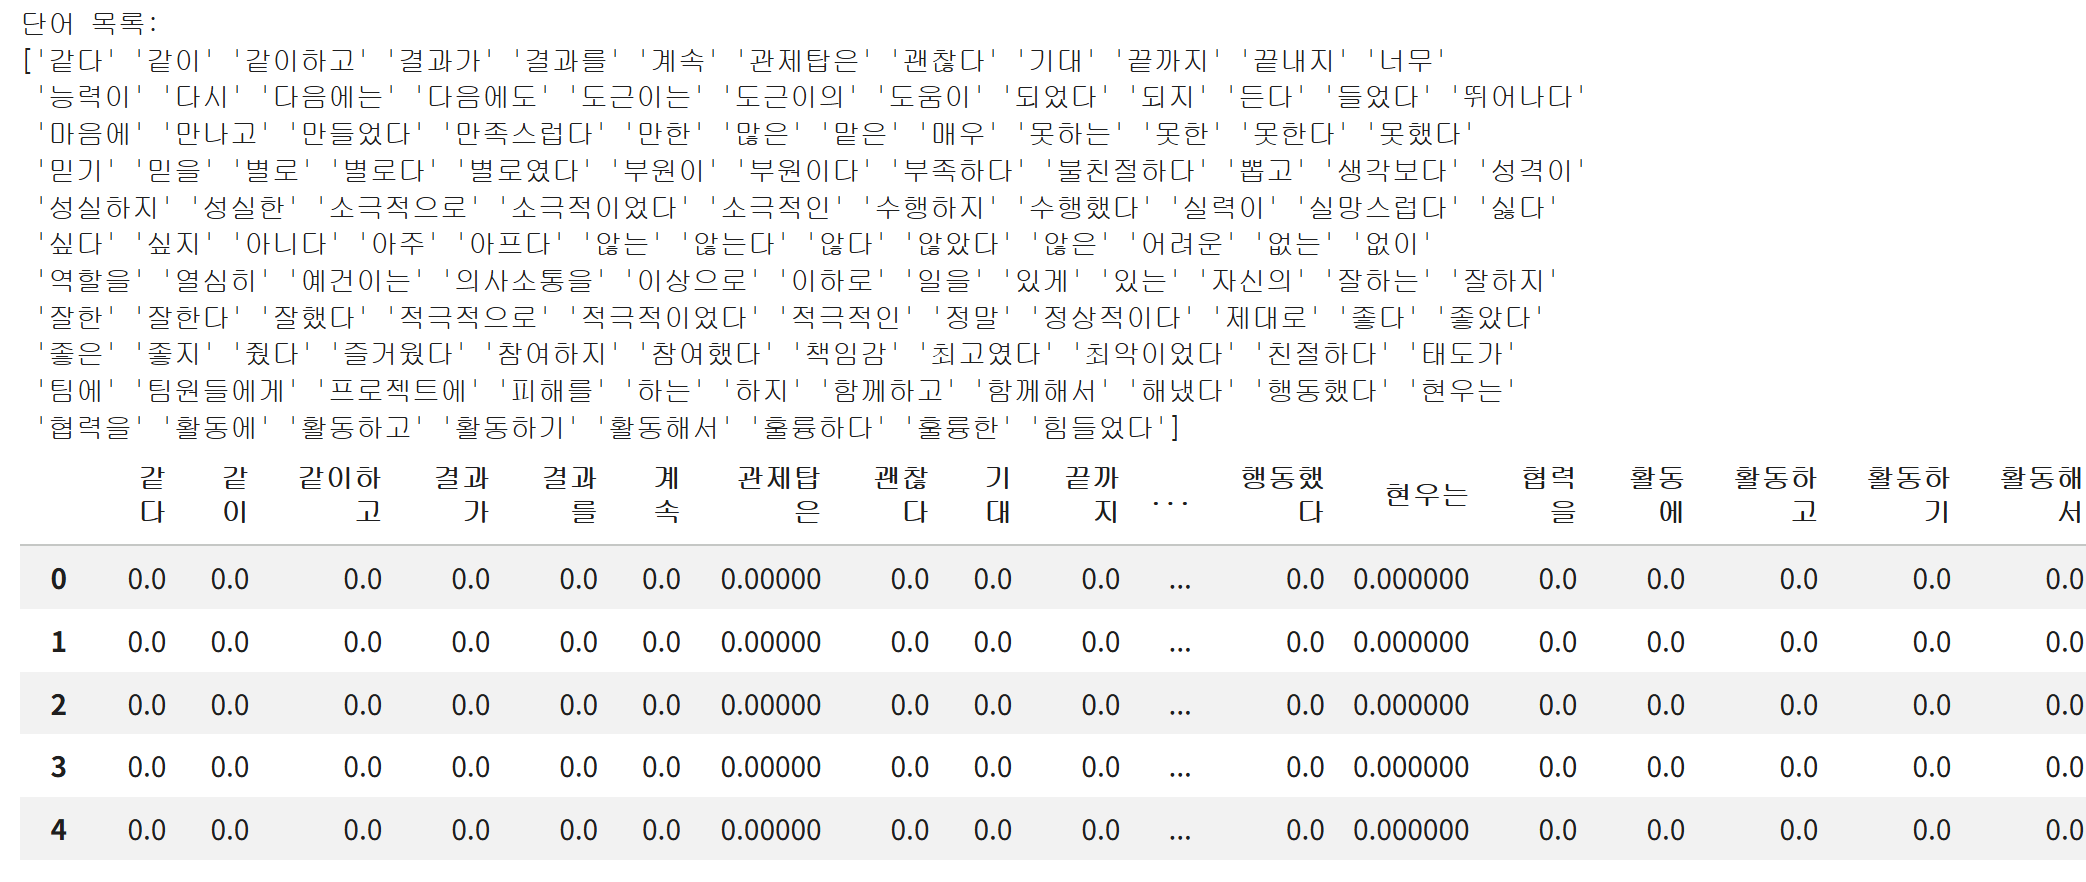
df = pd.DataFrame( X.toarray(), columns=vectorizer.get_feature_names_out())df셀 4에서는 전처리된 문장을 TF-IDF 방식의 숫자 벡터로 변환한다. TfidfVectorizer()로 변환기를 만들고, fit_transform()을 사용해 clean_texts에 등장하는 단어를 학습한 뒤 각 문장을 숫자로 변환한다. 변환된 결과는 X에 저장한다.
get_feature_names_out()은 모델이 학습한 전체 단어 목록을 출력한다. X.toarray()는 TF-IDF 결과를 배열 형태로 바꾸고, pd.DataFrame()은 이를 표 형태로 정리한다. 표의 행은 각 문장을 나타내고, 열은 단어를 나타낸다. 각 칸의 숫자는 해당 문장에서 그 단어가 가지는 중요도를 의미하며, 값이 클수록 중요한 단어라고 볼 수 있다.
(5) 모델 학습
# 셀 5. 모델 학습
model = LogisticRegression()model.fit(X,labels)
print("모델 학습 완료!")셀 5에서는 로지스틱 회귀 모델을 사용해 문장을 분류하는 방법을 학습한다. 먼저 LogisticRegression()으로 분류 모델을 만들고 model에 저장한다.
model.fit(X, labels)는 TF-IDF로 변환된 문장 데이터 X와 각 문장의 정답인 labels를 이용해 모델을 학습한다. 모델은 단어의 중요도와 긍정·부정의 관계를 학습하며, 새로운 문장이 입력되었을 때 긍정인지 부정인지 예측할 수 있게 된다. 학습이 끝나면 “모델 학습 완료!”라는 문장을 출력한다.
(6) 새로운 문장 테스트
# 셀 6 새로운 문장 직접 테스트
while True: sentence = input("문장 입력 (종료:q)")
if sentence.lower() == "q": print("테스트를 종료합니다.") break
cleaned = clean_text(sentence) new_X = vectorizer.transform([cleaned])
result = model.predict(new_X)[0] probability = model.predict_proba(new_X)[0]
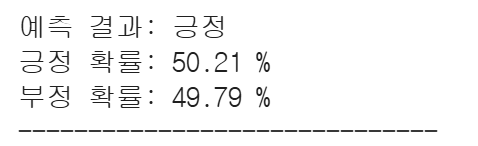
print("예측 결과:","긍정" if result == 1 else "부정") print("긍정 확률:",round(probability[1] * 100,2),"%") print("부정 확률:",round(probability[0] * 100,2),"%") print("-" * 30)셀 6에서는 사용자가 새로운 문장을 직접 입력해 모델의 예측 결과를 확인한다. while True를 사용해 문장을 반복해서 입력받으며, 사용자가 q를 입력하면 반복문을 종료한다. sentence.lower()를 사용하므로 대문자 Q를 입력해도 종료된다.
입력된 문장은 clean_text()로 전처리한 뒤, vectorizer.transform()을 사용해 학습할 때와 같은 TF-IDF 벡터로 변환한다. model.predict()는 문장이 긍정인지 부정인지 예측하고, model.predict_proba()는 긍정과 부정일 확률을 계산한다.
예측값이 1이면 “긍정”, 0이면 “부정”을 출력한다. 각 확률은 100을 곱해 백분율로 바꾸고 round()를 사용해 소수점 둘째 자리까지 표시한다. 이후 구분선을 출력하고 다음 문장을 입력받는다.