

1. 회귀란?
데이터 사이의 관계를 찾아 새로운 데이터의 값을 예측하는 머신러닝 방법이다.
기존 데이터를 학습하여 입력값과 결과값 사이에 어떤 관계가 있는지 찾고, 그 관계를 이용해 새로운 데이터의 결과값을 예측한다.
예) 공부 시간을 이용해 시험 점수 예측, 집의 크기를 이용해 집값 예측.
2. 독립변수, 종족변수
예측에 사용하는 값을 독립변수, 예측하려는 결과값을 종속변수라고 한다. 독립변수는 결과에 영향을 줄 수 있는 입력 데이터이고, 종속변수는 독립변수와의 관계를 바탕으로 예측하는 값이다.
예) 집값을 예측하는 경우
- 독립변수: 집의 크기, 방의 개수, 위치, 건축 연도 등
- 종속변수: 집값
즉, 여러 독립변수의 정보를 이용해 종속변수가 어떤 값이 될지 예측한다.
3. 과대 적합과 과소 적합
과대적합과 과소적합은 머신러닝 모델이 학습 데이터를 얼마나 잘 학습했는지를 나타내는 개념이다.
- 과대적합(Overfitting): 모델이 학습 데이터를 너무 자세하게 학습하여 학습 데이터에서는 성능이 좋지만 새로운 데이터에서는 성능이 떨어지는 현상이다. 데이터의 전체적인 특징뿐만 아니라 불필요한 부분이나 잡음까지 학습한 경우임
- 과소적합(Underfitting): 모델이 데이터를 충분히 학습하지 못하여 학습 데이터와 새로운 데이터 모두에서 성능이 낮은 현상이다. 즉, 데이터의 중요한 특징이나 관계를 제대로 찾지 못한 경우임
예를 들어 과대적합은 기출문제의 답만 외워서 비슷한 문제만 풀 수 있는 상태, 과소적합은 기본 개념조차 충분히 이해하지 못한 상태라고 볼 수 있다.
4. 단순 선형 회기
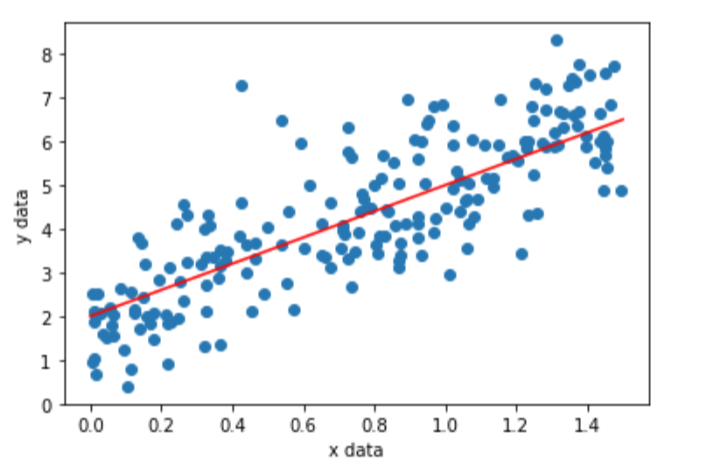
하나의 독립변수를 이용하여 하나의 종속변수를 예측하는 회귀 방법이다. 입력값과 결과값 사이의 관계를 하나의 직선으로 나타내어 새로운 값을 예측한다.
(1) 장점
- 구조가 단순하여 이해하고 해석하기 쉽다.
- 계산이 빠르고 결과를 직관적으로 확인할 수 있다.
(2) 단점
- 모든 데이터의 관계가 직선으로 나타나는 것은 아니기 때문에 현실의 복잡한 관계를 표현하기 어렵다. → 한계가 많다.
- 이상치가 있으면 예측 결과에 큰 영향을 받을 수 있다.
(3) 실습
(1) 데이터 불러오기
import matplotlib.pyplot as pltfrom sklearn.datasets import load_diabetesfrom sklearn.model_selection import train_test_splitfrom sklearn.linear_model import LinearRegressionfrom sklearn.metrics import mean_squared_error, r2_score, mean_absolute_error
# 데이터 불러오기diabetes = load_diabetes()단순 선형 회귀 실습을 위해 필요한 라이브러리와 당뇨병 데이터셋을 불러오는 역할을 한다.
matplotlib을 사용해 데이터를 그래프로 시각화할 수 있도록 하고, sklearn에서 제공하는 당뇨병 데이터셋을 불러 올 수 있다.
데이터를 학습용과 테스트용으로 나누기 위한 train_test_split과 선형 회귀 모델을 만들기 위한 LinearRegression을 불러온다.
마지막으로 평균 제곱 오차, 결정계수, 평균 절대 오차를 이용해 모델의 예측 성능을 평가할 수 있도록한다.
(2) BMI 데이터와 결과 값 설정 및 데이터 정보 확인
#BMI 데이터와 결과 값 설정X = diabetes.data[:, [2]]y = diabetes.target
#데이터 정보 확인print("데이터 크기 :",X.shape)print("데이터 개수 :",len(X))당뇨병 데이터에서 BMI에 해당하는 값만 독립변수 X로 설정하고, 질병 진행 정도를 종속변수 y로 설정한다. 이후 X의 shape와 len을 출력하여 데이터가 몇 개의 행과 열로 구성되어 있는지, 전체 데이터의 개수가 몇 개인지 확인한다.
(3) 데이터 분리와 학습
#학습 데이터와 테스트 데이터 분리X_train, X_test, y_train, y_test = train_test_split( X, y, test_size=0.2, random_state=42)
# 선형 회기 모델 생성model = LinearRegression()
# 모델 학습model.fit(X_train, y_train)
# 결과 예측prediction = model.predict(X_test)
#예측 결과 확인print("========예측 결과========")
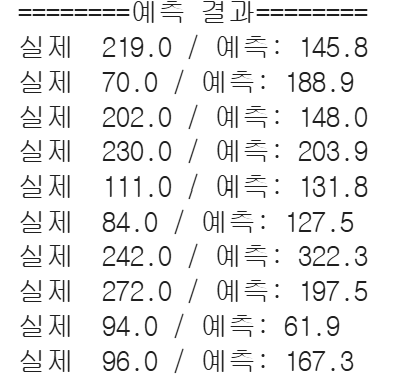
for i in range(10): print("실제 ",y_test[i],"/ 예측:",round(prediction[i],1))전체 데이터를 학습용 데이터와 테스트용 데이터로 나누고, 테스트 데이터는 전체의 20%가 되도록 설정한다. 이후 LinearRegression을 이용해 선형 회귀 모델을 생성하고, 학습 데이터를 사용하여 BMI와 질병 진행 정도 사이의 관계를 학습시킨다. 학습이 끝난 모델에 테스트 데이터를 입력하여 결과값을 예측하고, 실제 값과 예측 값을 비교할 수 있도록 처음 10개의 결과를 출력한다.
(4) 모델 성능 평가 및 결과 확인
#모델 성능 평가mae = mean_absolute_error(y_test, prediction)r2 = r2_score(y_test, prediction)
print("평균 절대 오차 MAE:", round(mae,2))print("R^2 점수:", round(r2,2))
#회귀선 그리기X_sorted = sorted(X_test[:,0])y_sorted = model.predict([[x] for x in X_sorted])
plt.scatter(X_test,y_test)plt.plot(X_sorted,y_sorted)
plt.xlabel("BMI")plt.ylabel("Disease Progression")plt.title("Simple Lonear Regression")
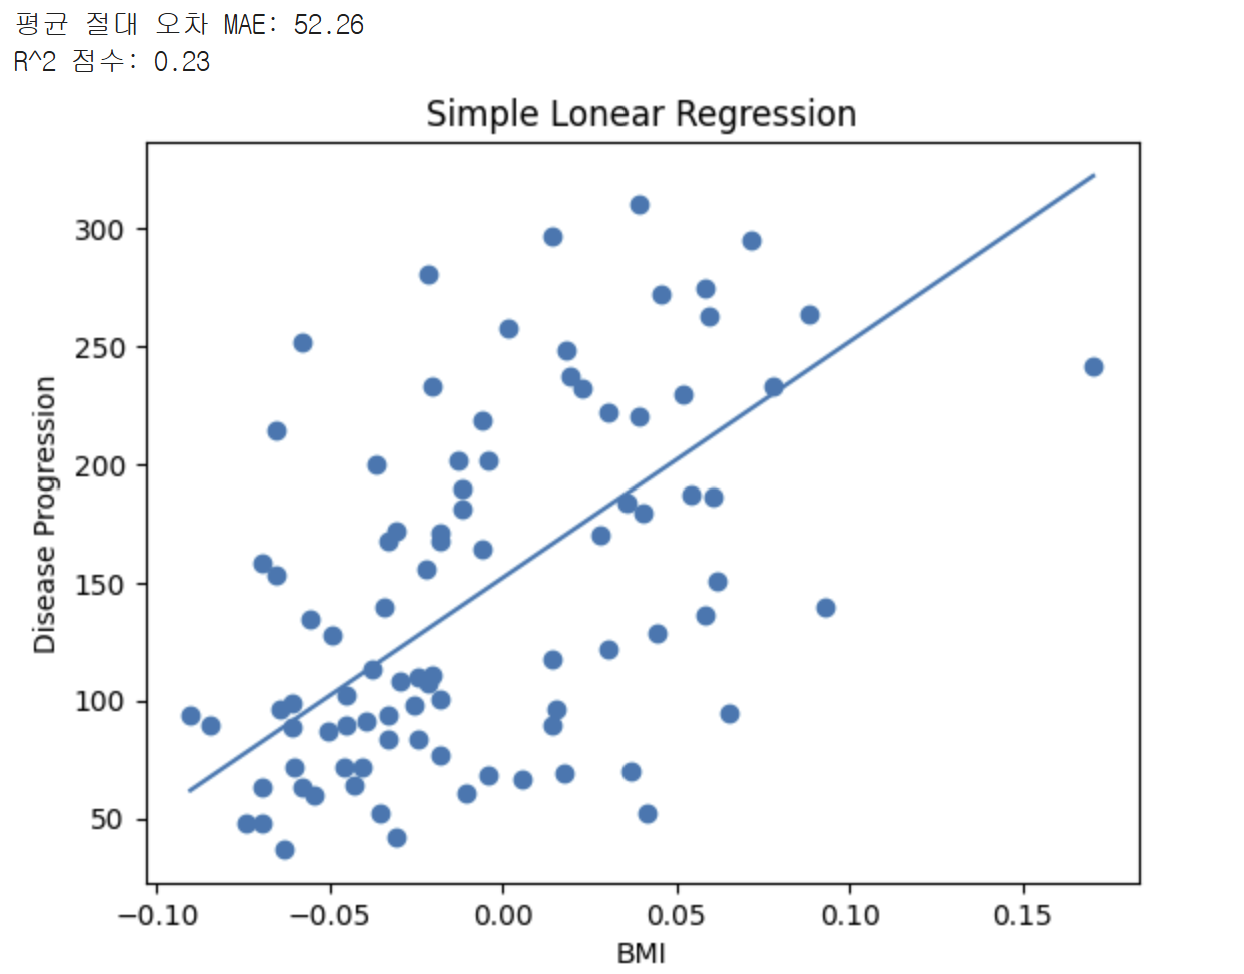
plt.show()학습한 선형 회귀 모델의 성능을 확인하기 위해 평균 절대 오차(MAE)와 결정계수(R²)를 계산한다. MAE는 실제 값과 예측 값의 차이가 평균적으로 얼마나 나는지를 나타내며, 값이 작을수록 예측 오차가 적다는 의미이다. R²는 모델이 데이터의 변화를 얼마나 잘 설명하는지를 나타내는 지표이다. 이후 테스트 데이터의 BMI 값을 순서대로 정렬하고 모델의 예측값을 구해 회귀선을 만든다. 실제 데이터는 산점도로 표시하고 예측 결과는 직선으로 나타내어 BMI와 질병 진행 정도 사이의 관계를 시각적으로 확인한다.
5. 다중 선형 회귀
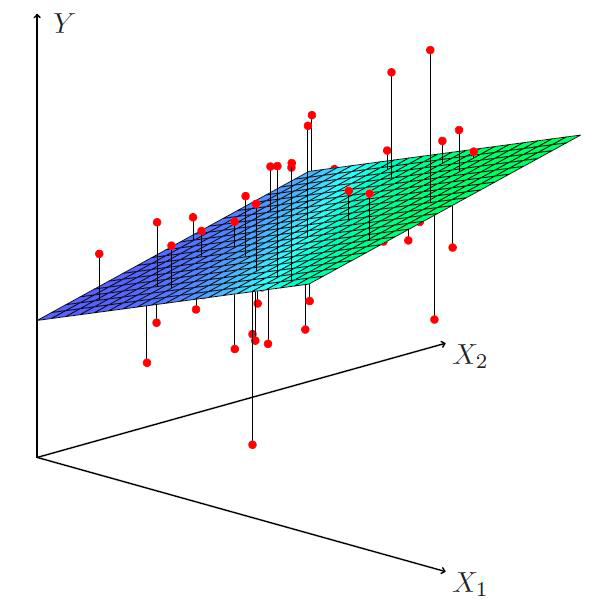
여러 개의 독립변수를 이용하여 하나의 종속변수를 예측하는 회귀 방법이다. 각각의 독립변수가 결과값에 어떤 영향을 주는지 함께 분석하여 예측한다.
(1) 장점
- 여러 요인을 동시에 고려하여 결과값을 예측할 수 있다.
- 단순 선형 회귀보다 현실의 복잡한 문제를 표현하기에 적합하다.
(2) 단점
- 독립변수들 사이의 상관관계가 너무 높으면 모델의 정확도와 해석력이 떨어질 수 있다.
- 사용하는 변수가 많아질수록 모델이 복잡해지고 불필요한 변수가 포함될 가능성이 있다.
6. 다항 회귀
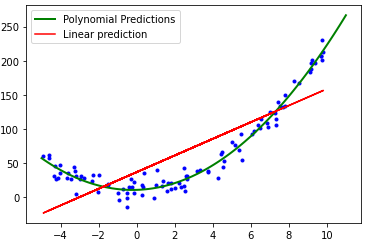
데이터 사이의 관계를 직선이 아닌 곡선 형태로 표현하여 결과값을 예측하는 회귀 방법이다. 독립변수를 제곱, 세제곱 등의 형태로 변환하여 복잡한 비선형 관계를 학습한다.
(1) 장점
- 직선으로 표현하기 어려운 비선형 관계를 설명할 수 있다.
- 데이터의 변화가 곡선 형태일 때 더 적절한 예측이 가능하다.
(2) 단점
- 차수가 너무 높아지면 학습 데이터에 지나치게 맞춰지는 과대적합이 발생할 수 있다.
- 차수가 높아질수록 모델이 복잡해져 결과를 해석하기 어려워질 수 있다.
7. 비선형 회귀
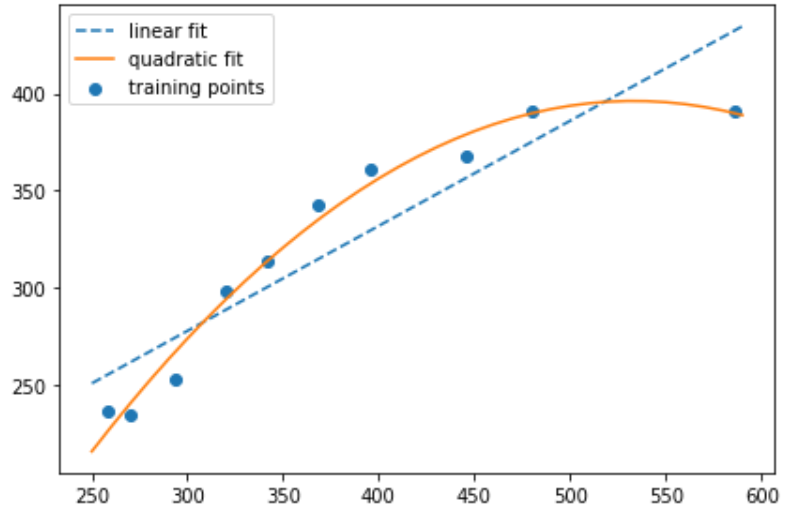
입력값과 결과값의 관계가 직선 형태로 표현되지 않을 때 사용하는 회귀 방법이다. 데이터의 관계를 곡선이나 특정 함수 형태로 표현하여 복잡한 변화를 예측한다.
(1) 장점
- 선형 회귀로 설명하기 어려운 복잡한 관계까지 표현할 수 있다.
- 데이터의 실제 변화 형태에 더 잘 맞는 모델을 만들 수 있다.
(2) 단점
- 데이터의 관계에 맞는 함수 형태를 미리 가정해야 하는 경우가 많다.
- 함수 형태를 잘못 선택하면 예측 성능이 크게 떨어질 수 있다.
8. 선형 데이터와 비선형 데이터
(1) 선형 데이터
입력값이 변할 때 결과값도 일정한 방향과 비율에 가깝게 변하여 하나의 직선으로 표현할 수 있는 데이터이다. 입력값이 증가하거나 감소함에 따라 결과값도 일정한 형태로 변화한다.
예시
- 1차 함수
- 공부 시간이 늘어날수록 점수가 일정하게 증가하는 경우
(2) 비선형 데이터
입력값이 변할 때 결과값의 변화가 일정하지 않아 하나의 직선으로 표현하기 어려운 데이터이다. 주로 곡선 형태의 관계를 나타낸다.
예시
- 2차 함수
- 지수 함수
- 로그 함수
9. 규제를 사용하는 회귀
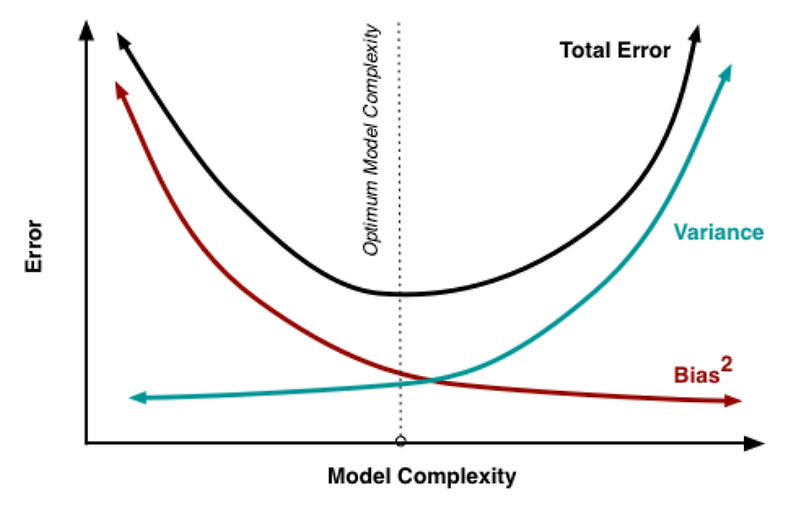
회귀 모델이 학습 데이터에 지나치게 맞춰지도록 너무 복잡하게 만들어지면 과적합이 발생할 수 있다.
이를 방지하기 위해 모델의 복잡도를 제한하고, 특정 변수의 영향이 지나치게 커지지 않도록 조절하는 방법을 규제라고 한다.
목적
- 과적합을 줄여 새로운 데이터에서도 좋은 성능을 내도록 한다.
- 모델이 지나치게 복잡해지는 것을 방지한다.
- 특정 독립변수에 지나치게 의존하는 것을 줄인다.
10. 릿지 회귀
특정 독립변수의 영향력이 지나치게 커지는 것을 막고, 여러 변수를 비교적 안정적으로 사용하도록 만드는 회귀 방법이다. 각 변수의 계수가 너무 커지지 않도록 규제를 적용하여 모델의 복잡도를 줄인다.
(1) 장점
- 과적합을 줄이는 데 효과적이다.
- 여러 변수를 안정적으로 사용할 수 있어 예측 성능이 비교적 안정적이다.
(2) 단점
- 중요하지 않은 변수의 계수를 줄일 수는 있지만 완전히 0으로 만들지는 않기 때문에, 불필요한 변수가 모델에 남아 있을 수 있다.
(3) 실습
(1) 데이터 불러오기 및 입력값 설정
import matplotlib.pyplot as pltfrom sklearn.datasets import load_diabetesfrom sklearn.model_selection import train_test_splitfrom sklearn.linear_model import Ridgefrom sklearn.metrics import mean_squared_error, r2_score, mean_absolute_error
# 데이터 불러오기diabetes = load_diabetes()
# 입력값과 결과값 설정X = diabetes.datay = diabetes.target릿지 회귀 실습에 필요한 라이브러리와 당뇨병 데이터셋을 불러온다. 이후 diabetes.data에 저장된 여러 특성값을 독립변수 X로 설정하고, 당뇨병의 질병 진행 정도를 종속변수 y로 설정한다.
(2) 데이터 분리 및 릿지 회귀 모델 학습
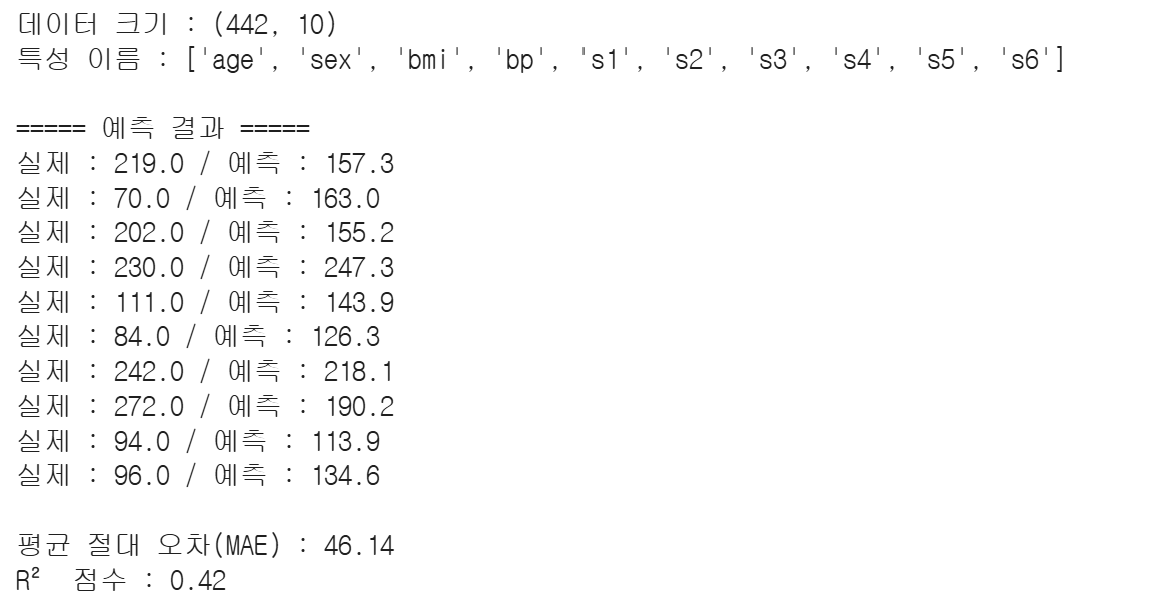
# 데이터 정보 확인print("데이터 크기 :", X.shape)print("특성 이름 :", diabetes.feature_names)
# 학습 데이터와 테스트 데이터 분리X_train, X_test, y_train, y_test = train_test_split( X, y, test_size=0.2, random_state=42)
# 릿지 회귀 모델 생성model = Ridge(alpha=1.0)
# 모델 학습model.fit(X_train, y_train)
# 결과 예측prediction = model.predict(X_test)
# 예측 결과 확인print("\n===== 예측 결과 =====")
for i in range(10): print( "실제 :", y_test[i], "/ 예측 :", round(prediction[i], 1) )
# 모델 성능 평가mae = mean_absolute_error(y_test, prediction)r2 = r2_score(y_test, prediction)
print("\n평균 절대 오차(MAE) :", round(mae, 2))print("R² 점수 :", round(r2, 2))데이터의 크기와 특성 이름을 확인한 뒤, 전체 데이터를 학습용 데이터와 테스트용 데이터로 나눈다. 테스트 데이터는 전체의 20%로 설정한다. 이후 alpha=1.0으로 릿지 회귀 모델을 생성하고 학습 데이터를 이용해 모델을 학습시킨다. 학습이 끝난 모델로 테스트 데이터의 결과값을 예측한 뒤 실제 값과 예측 값을 비교한다. 마지막으로 MAE와 R² 점수를 계산하여 모델의 예측 오차와 성능을 확인한다.
(3) 특성별 계수 확인 및 규제 강도 비교
import matplotlib.pyplot as plt
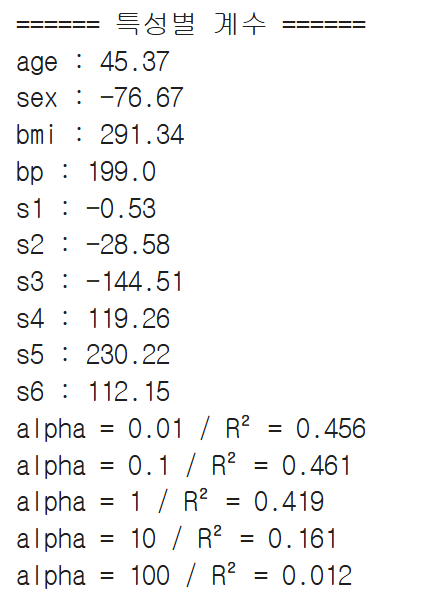
# 특성별 계수 확인print("====== 특성별 계수 ======")for name,coef in zip(diabetes.feature_names,model.coef_): print(name,":",round(coef,2))
# 규제 강도별 성능 비교alpha_list = [0.01,0.1,1,10,100]scores = []
for alpha in alpha_list: test_model = Ridge(alpha=alpha) test_model.fit(X_train,y_train) test_prediction = test_model.predict(X_test)
test_score = r2_score(y_test,test_prediction) scores.append(test_score)
print("alpha =",alpha,"/ R²=",round(test_score,3))
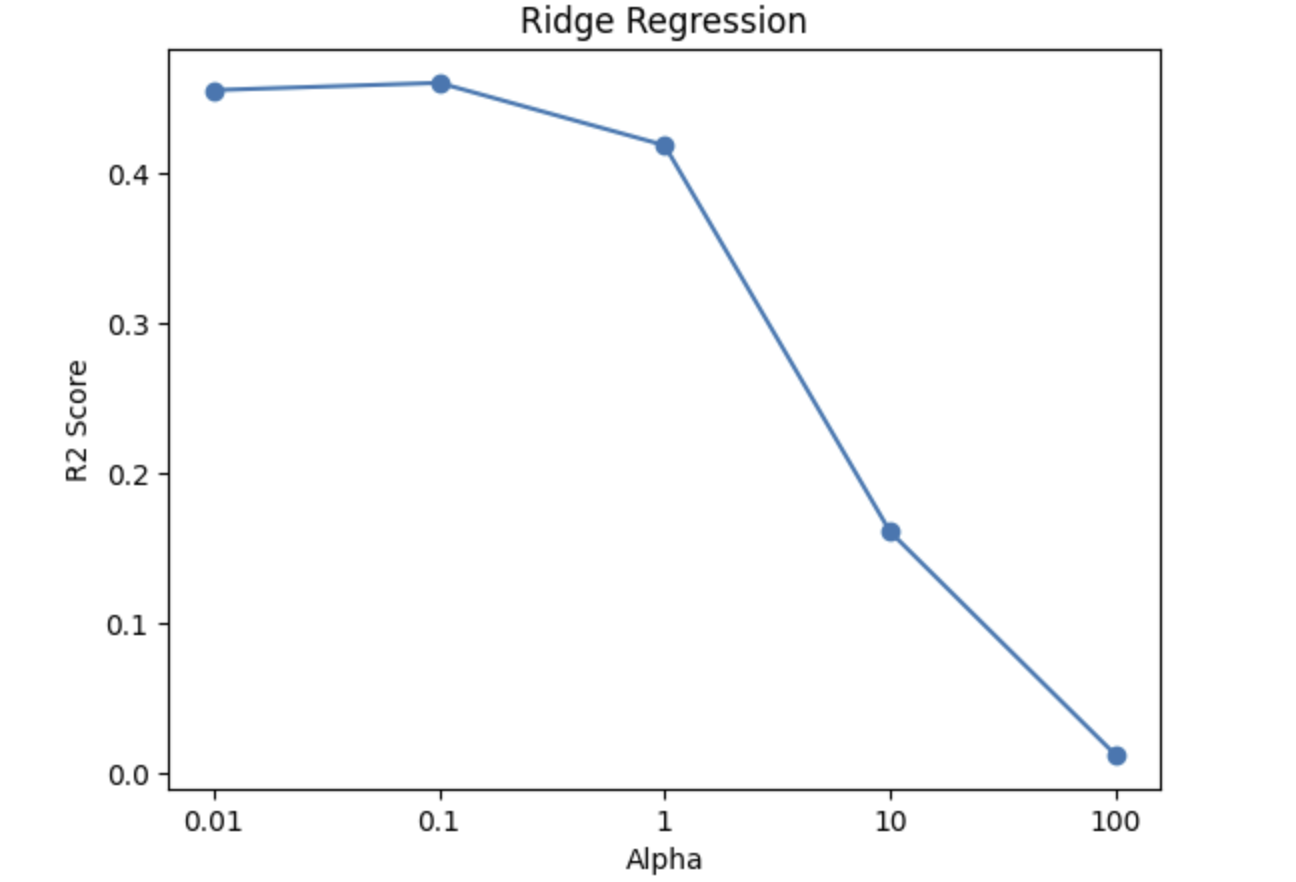
# 규제 강도별 성능 그래프plt.plot(range(len(alpha_list)),scores,marker='o')plt.xticks(range(len(alpha_list)),alpha_list)
plt.xlabel("Alpha")plt.ylabel("R2 Score")plt.title("Ridge Regression")
plt.show()학습된 릿지 회귀 모델에서 각 특성이 결과값에 얼마나 영향을 주는지 계수를 확인한다. 이후 alpha 값을 0.01, 0.1, 1, 10, 100으로 바꾸어가며 여러 개의 릿지 회귀 모델을 학습시키고, 각 모델의 R² 점수를 계산하여 규제 강도에 따른 성능 차이를 비교한다. 마지막으로 alpha 값과 R² 점수를 그래프로 나타내어 어떤 규제 강도에서 모델의 성능이 좋은지 확인한다.
11. 라쏘 회귀
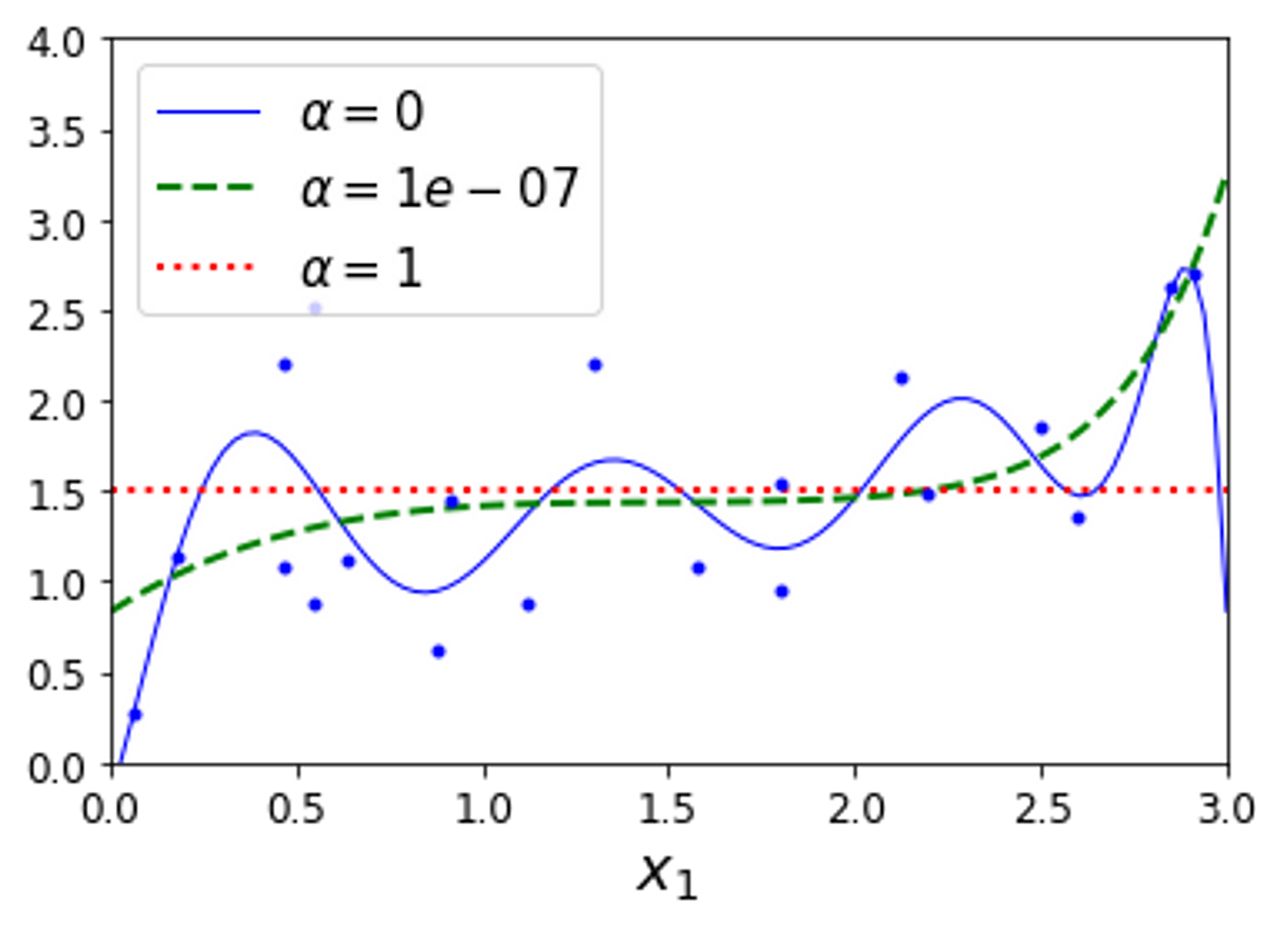
중요도가 낮은 독립변수의 계수를 0으로 만들어 불필요한 변수를 제거하는 회귀 방법이다. 규제를 통해 모델을 단순하게 만들고, 예측에 중요한 변수만 남도록 한다.
(1) 장점
- 불필요한 변수를 자동으로 제거할 수 있다.
- 중요한 변수만 남기 때문에 모델의 해석력이 높아진다.
- 과적합을 줄이는 데 도움이 된다.
(2) 단점
- 변수가 많고 서로 강한 상관관계를 가지고 있으면 어떤 변수를 남길지 불안정해질 수 있다.
- 중요한 변수까지 제거될 가능성이 있다.
12. 엘라슽틱넷 회귀
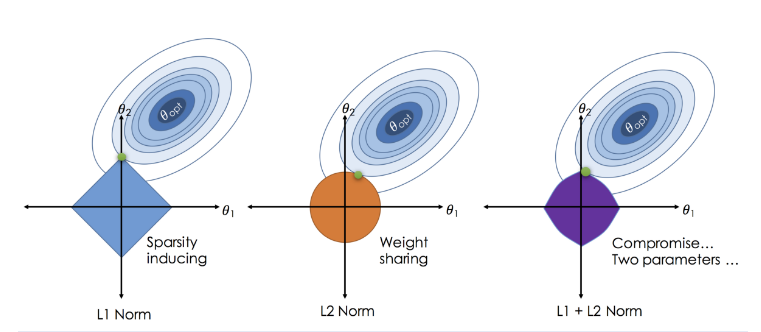
릿지 회귀와 라쏘 회귀의 특징을 함께 사용하는 회귀 방법이다. 변수의 영향력이 지나치게 커지는 것을 줄이는 동시에, 중요하지 않은 변수의 계수를 0으로 만들어 불필요한 변수를 제거할 수 있다.
(1) 장점
- 릿지와 라쏘의 장점을 함께 활용할 수 있다.
- 과적합을 줄이면서 불필요한 변수도 제거할 수 있다.
- 변수들이 서로 강하게 연관되어 있을 때도 비교적 안정적으로 사용할 수 있다.
(2) 단점
- 릿지와 라쏘의 규제 비율을 함께 조절해야 하므로 설정이 복잡하다.
- 적절한 규제 강도와 비율을 찾는 과정이 필요하다.
13. 로지스틱 회귀
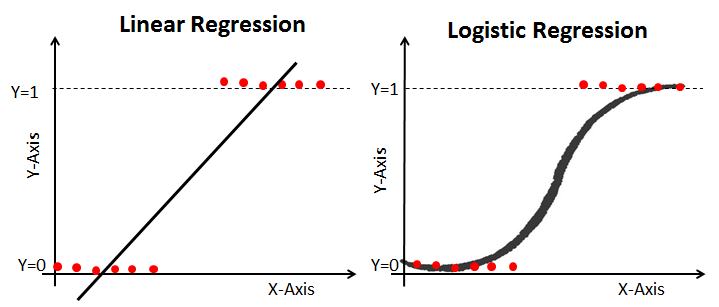
이름에는 회귀가 들어가 있지만 주로 분류 문제에 사용하는 머신러닝 알고리즘이다. 입력 데이터를 바탕으로 데이터가 특정 종류에 속할 확률을 계산한 뒤, 그 확률을 기준으로 분류 결과를 결정한다.
(1) 장점
- 계산 속도가 빠르고 구조가 단순하다.
- 각 변수의 영향력을 비교적 쉽게 해석할 수 있다.
- 이진 분류 문제에서 효과적으로 사용할 수 있다.
(2) 단점
- 복잡한 비선형 관계를 가진 데이터를 잘 표현하지 못한다.
- 데이터의 관계가 복잡할수록 분류 성능이 떨어질 수 있다.