

1. 머신 러닝이란?
머신러닝은 컴퓨터가 데이터를 바탕으로 규칙과 특징을 스스로 학습하고, 학습한 내용을 활용해 새로운 데이터의 결과를 예측하거나 판단하는 기술이다.
2. 머신 러닝의 차이점
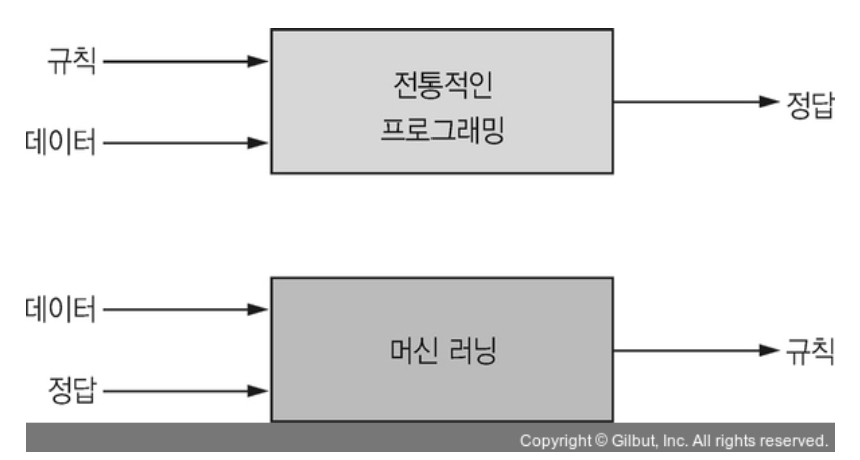
(1) 전통적인 프로그래밍
전통적인 프로그래밍은 사람이 규칙을 직접 만들고, 컴퓨터는 그 규칙에 따라 결과를 출력하는 방식이다.
(2) 머신러닝
머신러닝은 데이터와 정답을 컴퓨터에 제공하면, 컴퓨터가 그 안에서 규칙을 스스로 찾아 새로운 결과를 예측하는 방식이다.
전통적인 프로그래밍은 사람이 규칙을 직접 작성해야 하지만, 머신러닝은 컴퓨터가 데이터를 통해 규칙을 학습한다는 차이가 있다.
3. 머신 러닝의 사례
알고리즘
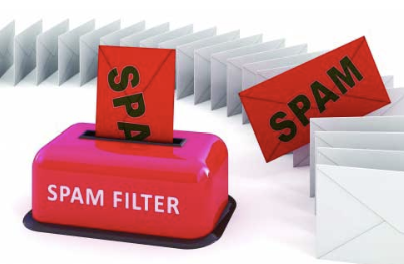
스팸 메일 분류
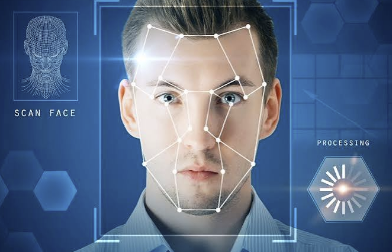
얼굴 인식
상품 추천
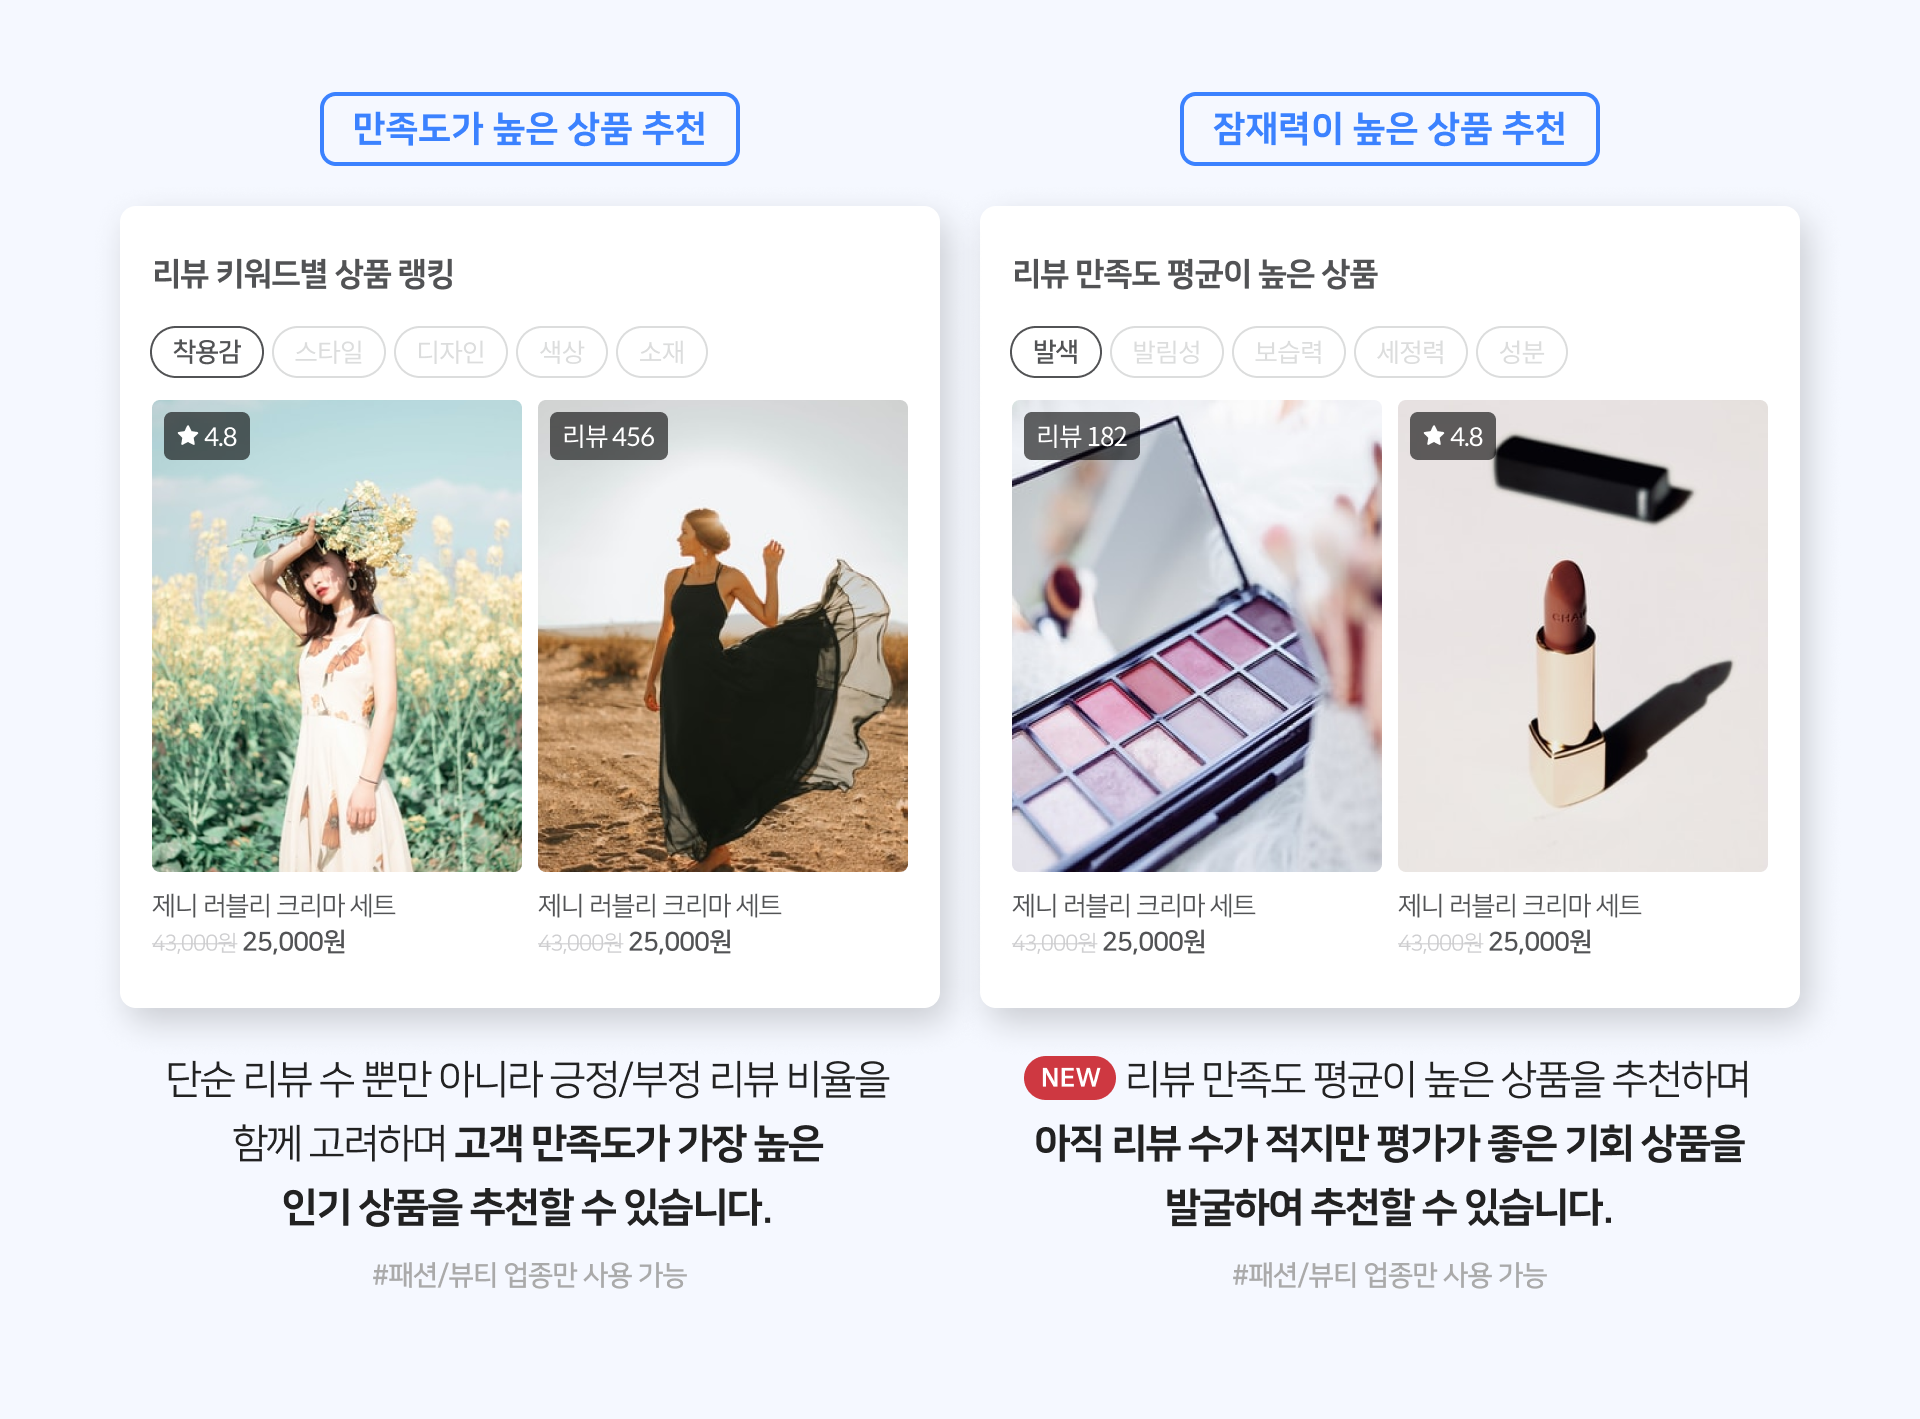
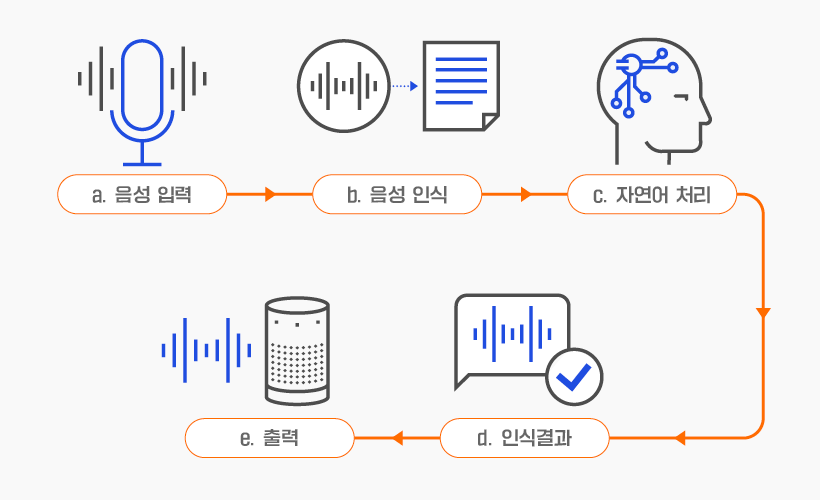
음성 인식
4. 데이터란?
데이터는 관찰, 측정, 조사 등을 통해 얻은 숫자, 문자, 이미지 등의 자료로, 분석하거나 학습하는 데 사용되는 정보이다.
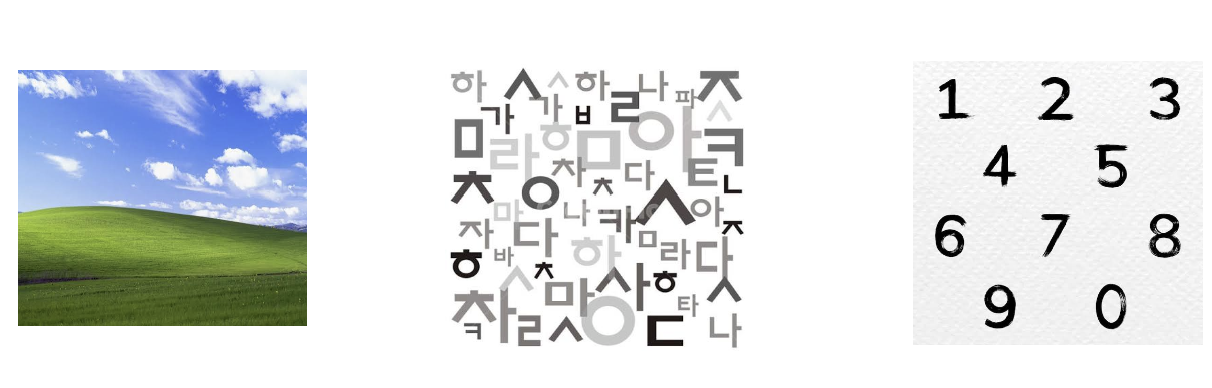
5. 데이터의 종류
- 학습 데이터: 머신러닝 모델을 학습시키기 위해 사용하는 데이터이다. 데이터의 특징과 정답을 함께 제공하여, 컴퓨터가 규칙을 찾도록 한다.
- 테스트 데이터: 학습이 끝난 모델의 성능을 확인하기 위해 사용하는 데이터이다. 학습에 사용하지 않은 데이터를 이용해 모델이 얼마나 정확하게 예측하는지 평가한다.
6. 머신 러닝의 학습 과정
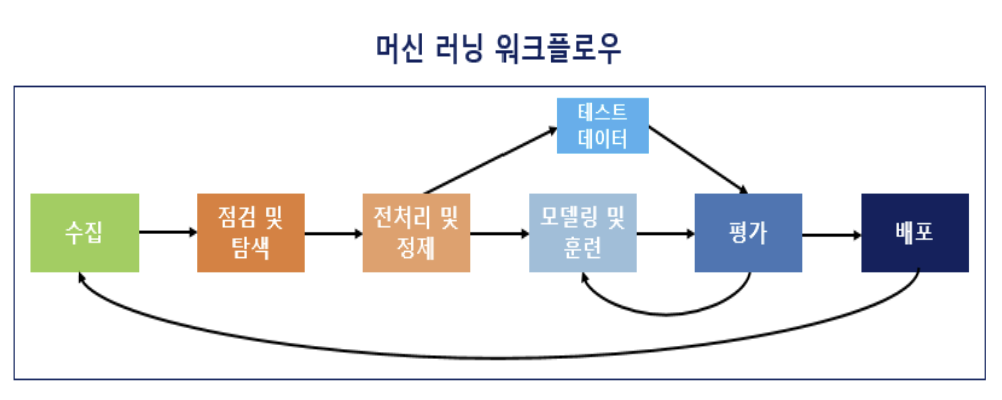
- 데이터 수집: 머신러닝에 사용할 데이터를 모은다.
- 데이터 점검 및 탐색: 데이터의 형태, 분포, 오류, 결측값 등을 확인한다.
- 데이터 전처리 및 정제: 학습에 방해되는 데이터를 정리하고 필요한 형태로 변환한다.
- 테스트 데이터 분리: 전체 데이터 중 일부를 테스트용으로 따로 나눈다.
- 모델링 및 훈련: 데이터를 이용해 머신러닝 모델을 학습시킨다.
- 평가: 테스트 데이터를 이용해 모델의 성능을 확인한다.
- 모델 개선: 성능이 부족하면 데이터나 모델을 수정해 다시 학습한다.
- 배포: 완성된 모델을 실제 서비스에 적용한다.
- 재수집 및 개선: 새로운 데이터를 수집해 모델을 지속적으로 개선한다.
7. 머신러닝의 종류
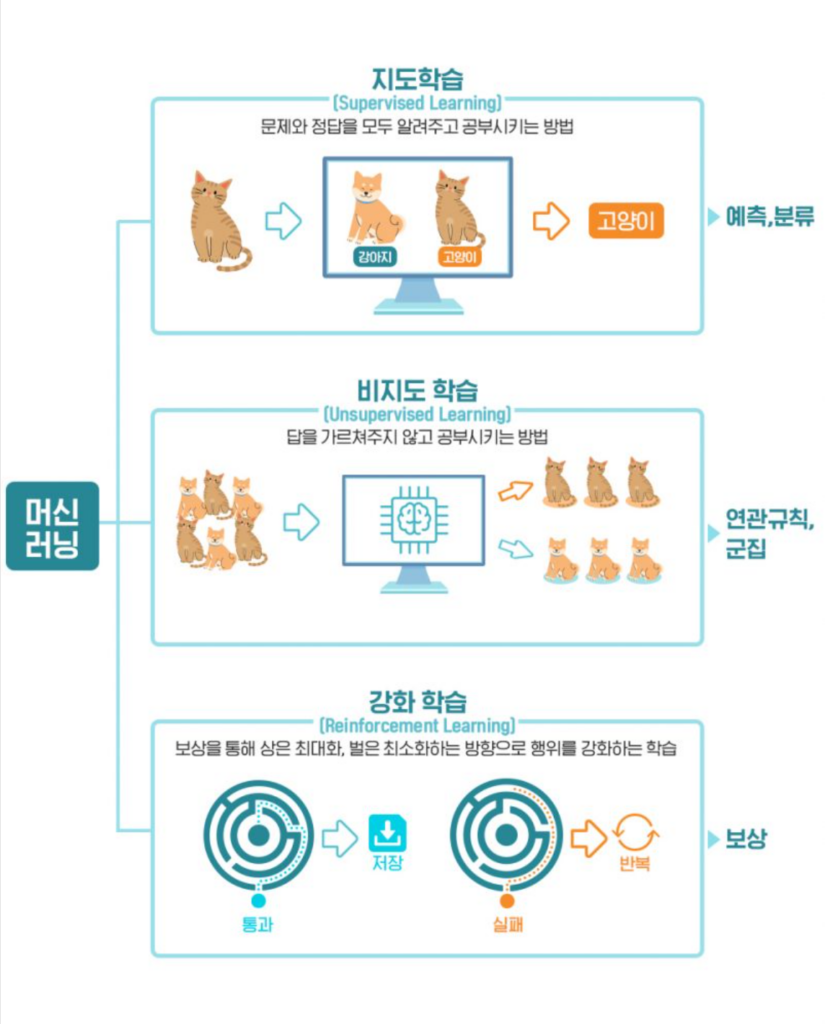
지도 학습
정답이 있는 데이터를 이용해 학습하는 방법이다. 입력 데이터와 그에 대한 정답을 함께 제공하여, 새로운 데이터가 들어왔을 때 결과를 예측하도록 한다.
- 예시: 스팸 메일 분류, 집값 예측, 이미지 분류
비지도 학습
정답이 없는 데이터를 이용해 데이터의 구조나 특징을 찾는 방법이다. 비슷한 데이터를 그룹으로 묶거나, 데이터의 숨겨진 패턴을 발견하는 데 사용된다.
- 예시: 고객 유형 분류, 추천 시스템, 이상치 탐지
강화 학습
행동에 대한 보상을 통해 학습하는 방법이다. 컴퓨터가 여러 행동을 시도하면서 좋은 결과를 얻는 행동을 학습한다.
- 예시: 게임 AI, 자율주행 자동차, 로봇 제어
8. 머신 러닝의 장단점
장점
- 많은 데이터를 빠르게 분석할 수 있다.
- 사람이 직접 규칙을 만들지 않아도 된다.
- 사람이 찾기 어려운 패턴을 발견할 수 있다.
단점
- 많은 데이터가 필요하다.
- 데이터가 좋지 않으면 결과도 좋지 않다.
9. 실습
(1) 필요한 도구 불러오기
from sklearn.datasets import load_irisfrom sklearn.model_selection import train_test_splitfrom sklearn.tree import DecisionTreeClassifierfrom sklearn.metrics import accuracy_scorescikit-learn은 파이썬에서 머신러닝을 쉽게 사용할 수 있도록 도와주는 라이브러리다. 여기서는 붓꽃 데이터를 불러오고, 학습용·테스트용 데이터를 나누며, 의사결정 트리 모델의 정확도를 확인한다.
(2) 붓꽃 데이터 불러오기
# 1. 붓꽃 데이터 불러오기iris = load_iris()
# x는 꽃의 특징 데이터# 꽃받침 길이, 꽃받침 너비, 꽃잎 길이, 꽃잎 너비가 들어있음X = iris.data
# y는 꽃의 정답 데이터# 0 = setosa# 1 = versicolor# 2 = virginicay = iris.targetX에는 꽃받침 길이·너비와 꽃잎 길이·너비가, y에는 꽃의 종류 정답이 들어 있다. 값 0, 1, 2는 각각 setosa, versicolor, virginica를 의미한다.
(3) 학습 데이터와 테스트 데이터로 나누기
# 2. 학습 데이터와 테스트 데이터로 나누기# 전체 데이터의 80%는 학습용, 20%는 확인용X_train, X_test, y_train, y_test = train_test_split( X, y, test_size=0.2, random_state=42)전체 데이터의 80%는 학습에 사용하고, 나머지 20%는 학습이 끝난 뒤 성능을 확인하는 데 사용한다. random_state=42를 지정하면 실행할 때마다 같은 방식으로 데이터가 나뉜다.
(4) 머신러닝 모델 만들기
# 3. 머신러닝 모델 만들기# 의사결정 트리 모델 사용model = DecisionTreeClassifier(random_state=42)의사결정 트리는 질문을 여러 번 나누며 데이터를 분류하는 머신러닝 모델이다.
(5) 머신러닝 학습시키기
# 4. 머신러닝 학습시키기# 학습 데이터를 이용하여 꽃의 특징을 학습model.fit(X_train, y_train)
fit()은 학습 데이터의 특징과 정답을 이용해 모델이 분류 규칙을 찾도록 하는 함수다.
(6) 테스트 데이터로 꽃 종류 예측하기
# 5. 테스트 데이터로 꽃 종류 예측하기prediction = model.predict(X_test)학습에 사용하지 않은 테스트 데이터의 꽃 종류를 예측한다.
(7) 실제 정답과 예측 결과 출력
# 6. 실제 정답과 머신러닝의 예측 결과 출력print("[머신러닝 예측 결과]")print(prediction)[머신러닝 예측 결과][1 0 2 1 1 0 1 2 1 1 2 0 0 0 0 1 2 1 1 2 0 2 0 2 2 2 2 2 0 0]배열의 각 숫자는 테스트 데이터에 대한 모델의 예측 결과다.
(8) 정확도 계산하기
# 7. 정확도 계산하기accuracy = accuracy_score(y_test, prediction)print("")print("정확도:", accuracy * 100, "%")정확도: 100.0 %accuracy_score()는 실제 정답과 예측 결과가 일치하는 비율을 계산한다.
(9) 새로운 꽃 데이터 입력하기
# 8. 새로운 꽃 데이터 입력하기# 순서: 꽃받침 길이, 너비, 꽃잎 길이, 너비new_flower = [[5.1, 3.5, 1.4, 0.2]]새 꽃의 특징을 입력한다. 값의 순서는 꽃받침 길이, 꽃받침 너비, 꽃잎 길이, 꽃잎 너비다.
(10) 새로운 꽃 종류 예측하기
# 9. 새로운 꽃 종류 예측하기result = model.predict(new_flower)학습한 모델이 새로운 꽃의 종류를 예측한다.
(11) 예측 결과 출력하기
# 10. 예측 결과 출력하기print()print("[새로운 꽃 예측 결과]")print("꽃 번호:", result[0])print("꽃 종류:", iris.target_names[result[0]])[새로운 꽃 예측 결과]꽃 번호: 0꽃 종류: setosa입력한 특징을 바탕으로 모델은 이 꽃을 setosa로 예측했다.
(12) Colab
10. 머신 러닝 모델 조사하기
인공신경망 (Artificial Neural Network, ANN)
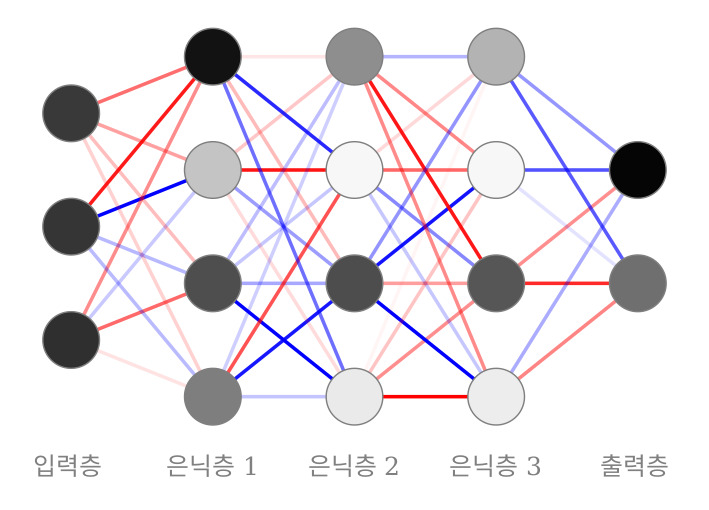
인공신경망은 사람의 뇌에 있는 신경세포의 연결 구조를 본떠 만든 머신러닝 모델이다. 여러 개의 인공 뉴런이 서로 연결되어 데이터를 입력받고, 반복적인 학습을 통해 데이터의 특징과 규칙을 찾아낸다.
인공신경망은 보통 입력층, 은닉층, 출력층으로 구성된다.
- 입력층: 데이터를 처음 입력받는 부분이다. 예를 들어 이미지의 픽셀 값이나 센서 데이터가 들어간다.
- 은닉층: 입력된 데이터를 여러 단계로 처리하면서 특징을 학습하는 부분이다. 은닉층이 많아질수록 복잡한 패턴을 학습할 수 있다.
- 출력층: 최종 결과를 출력하는 부분이다. 예를 들어 이미지가 고양이인지 개인지, 숫자가 무엇인지 등을 판단한다.
인공신경망은 이미지 인식, 음성 인식, 자연어 처리 등 복잡한 데이터를 다루는 분야에서 많이 사용된다. 장점은 복잡한 패턴을 학습할 수 있다는 것이고, 단점은 많은 데이터와 학습 시간이 필요하며 모델의 내부 동작을 이해하기 어려울 수 있다는 점이다.